NASA e IBM presentaron el Lunar Foundation Model (LFM), un sistema de inteligencia artificial de código abierto diseñado específicamente para analizar la superficie lunar. La herramienta ya está disponible de forma gratuita en Hugging Face, la plataforma colaborativa de modelos de IA, y su código completo puede consultarse en GitHub, lo que permite a cualquier investigador probarlo o adaptarlo a sus propios proyectos.
El modelo llega en un momento clave para el programa Artemis. En abril pasado, la misión Artemis II completó un sobrevuelo histórico alrededor de la Luna, el primer vuelo tripulado que se acerca al satélite desde 1972, con los astronautas Reid Wiseman, Christina Koch, Victor Glover y Jeremy Hansen a bordo. De cara a las próximas misiones, NASA e IBM buscaban una forma más eficiente de procesar las enormes cantidades de datos acumuladas durante décadas de observación lunar.
De acuerdo con Juan Bernabé-Moreno, director de IBM Research para Europa, Reino Unido e Irlanda, el sistema resultó particularmente eficaz para detectar zonas con posible presencia de hielo en la superficie lunar. En pruebas comparativas frente a SwinV2-B, un modelo de visión artificial de Microsoft utilizado habitualmente como referencia en análisis de imágenes, el modelo de NASA e IBM redujo los errores de predicción en un 23%. En la tarea de identificar y clasificar cráteres, superó a ese mismo sistema en un 19%, usando además la mitad de datos de entrenamiento.

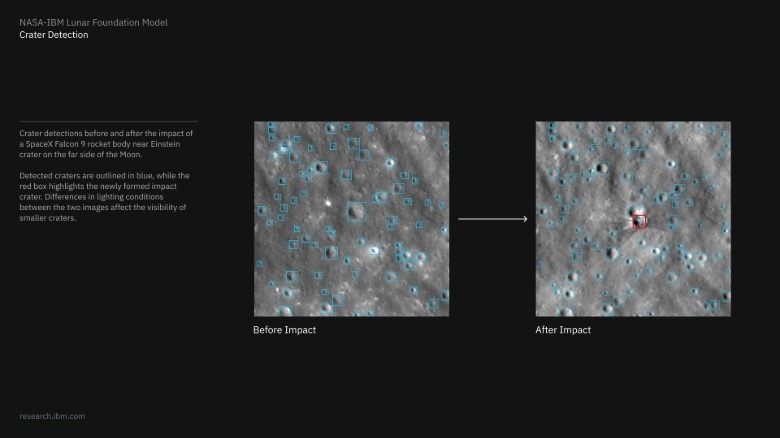
La validación más contundente llegó de forma casi accidental: cuando un cohete Falcon 9 de SpaceX impactó contra la Luna el 5 de agosto, el equipo alimentó al modelo con una imagen del sitio del choque. Pese a que el nuevo cráter se superponía parcialmente con uno ya existente, la inteligencia artificial identificó correctamente la formación en su primer intento, algo que Bernabé-Moreno calificó como un resultado «fantástico».
Entrenar el sistema no fue sencillo. A diferencia de las imágenes terrestres, donde la atmósfera dispersa la luz solar y suaviza las sombras, en la Luna las sombras son completamente negras y de bordes definidos, por lo que los píxeles en esas zonas no aportan información útil. Además, los métodos tradicionales de entrenamiento —que consisten en ocultar partes de una imagen para que el modelo las reconstruya— no funcionaban bien porque muchos cráteres lucen extremadamente parecidos entre sí vistos desde órbita. El equipo resolvió el problema dividiendo la superficie lunar en secciones, de forma similar a los gajos de una naranja, separando por completo los datos usados para entrenar el modelo de los usados para evaluarlo.
Además del modelo en sí, NASA e IBM publicaron un conjunto de datos abierto sin precedentes, que reúne más de dos millones de puntos de información provenientes de instrumentos de la sonda Lunar Reconnaissance Orbiter, la misión GRAIL y la sonda japonesa SELENE. Según Bernabé-Moreno, esa base de datos organizada podría tener un impacto científico incluso mayor que el propio modelo, ya que servirá como cimiento para el desarrollo de futuras herramientas de inteligencia artificial aplicadas a la exploración espacial.